はじめに
こんにちは、運用支援チームのkeitaです。
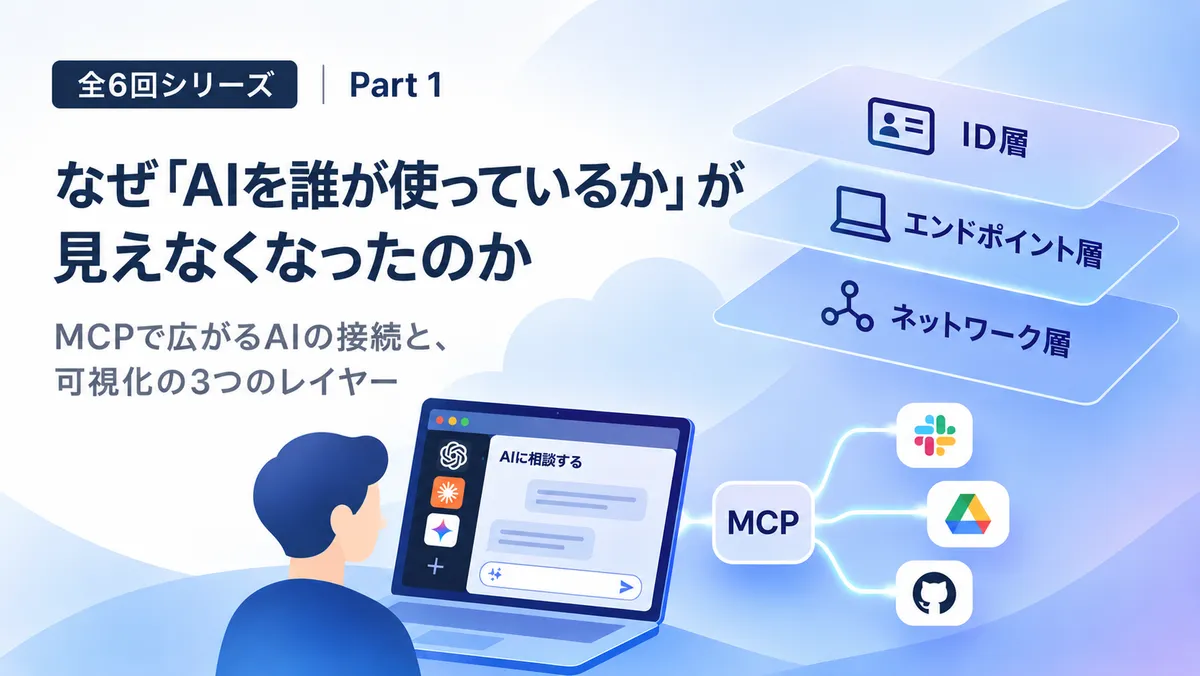
いま、Microsoft Entra の Global Secure Access(以下GSA)が持つAI検出系の機能を、実機で検証しています。分かったことを、この記事から全6回に分けて書いていきます。
第1回のこの記事では、検証結果にはまだ入りません。扱うのは、
- なぜ「AIを誰が使っているか」が見えなくなったのか
- 可視化のレイヤーは3つあり、それぞれ何が見えて何が見えないのか
- このシリーズをどういう立場で書くのか
の3点です。
この「見えなくなった」という話には、実は当社に先行するブログがあります。
会社が把握していないAI利用、いわゆるシャドーAIについては、当社のEimiさんのシャドーAIとは?最新調査と対策【2026年5月】が詳しく扱っています。定義も、シャドーITとの違いも、調査データも、対策の進め方も、そちらにまとまっています。
ただ、その記事が扱っていない論点が1つあります。AIが、自分で外部のツールを呼ぶようになったことです。AIが外部ツールを呼び出す仕組みは以前からありましたが、MCPという共通仕様によって、AIと外部サービスを連携させる方法が標準化されてきました。人がチャット欄に何を入力したかを見るだけでは、足りません。
本題に入る前に、ひとつだけ確認させてください。
社内で誰がどのAIサービスを使っているか、把握できているでしょうか。
「だいたい把握している」と答えられる会社でも、いま起きている変化のぶんだけ、その答えは怪しくなっています。
人間ではないIDが増え、管理が追いついていない
まず、規模感を確認しておきます。
人間ではないIDは、実際のところどれくらいあるのか。
2025年の調査になりますが、規模の分かるものとして、CyberArk の2025 Identity Security Landscapeがあります。これは、20か国・従業員500人以上の組織のサイバーセキュリティ意思決定者2,600人を対象にしたもので、そこにこう書かれています。
There are 82 machine identities for every human in organizations worldwide.
(世界の組織では、人間1人あたり82のマシンアイデンティティが存在する)
この調査では、マシンアイデンティティの数が人間のアイデンティティを大きく上回っています。マシンアイデンティティには、サービスアカウントやシステム間連携に使う資格情報など、さまざまなものが含まれます。82対1という数字はマシンアイデンティティ全般の比率であり、AIエージェントだけの数を示すものではありません。
NHI(Non-Human Identity)そのものについては、当社のShinjiさんのNHI(Non-Human Identity)管理が一気に立ち上がってきた件が詳しく扱っています。その記事は、AIエージェント特有の性質をこう書いています。
誰でもどこでもエージェントを作成でき、統一的なガバナンスが存在しない状態です。
Gartner も2026年のサイバーセキュリティトレンドで、「Agentic AI Demands Cybersecurity Oversight」と「Identity and Access Management Adapts to AI Agents」を独立した項目として挙げています。
ここまでは、増えているという話です。問題は、増えたものが何をしているのかが見えないことのほうにあります。
何が変わったか:AIが自分で外部とつながり始めた
これまでシャドーAIの問題としてよく取り上げられてきたのは、わりと素直な構図でした。人がブラウザを開いて、チャット欄に何かを貼り付ける。危ないのは貼り付けた中身で、見るべきは「誰が、どのサービスに、何を入力したか」でした。
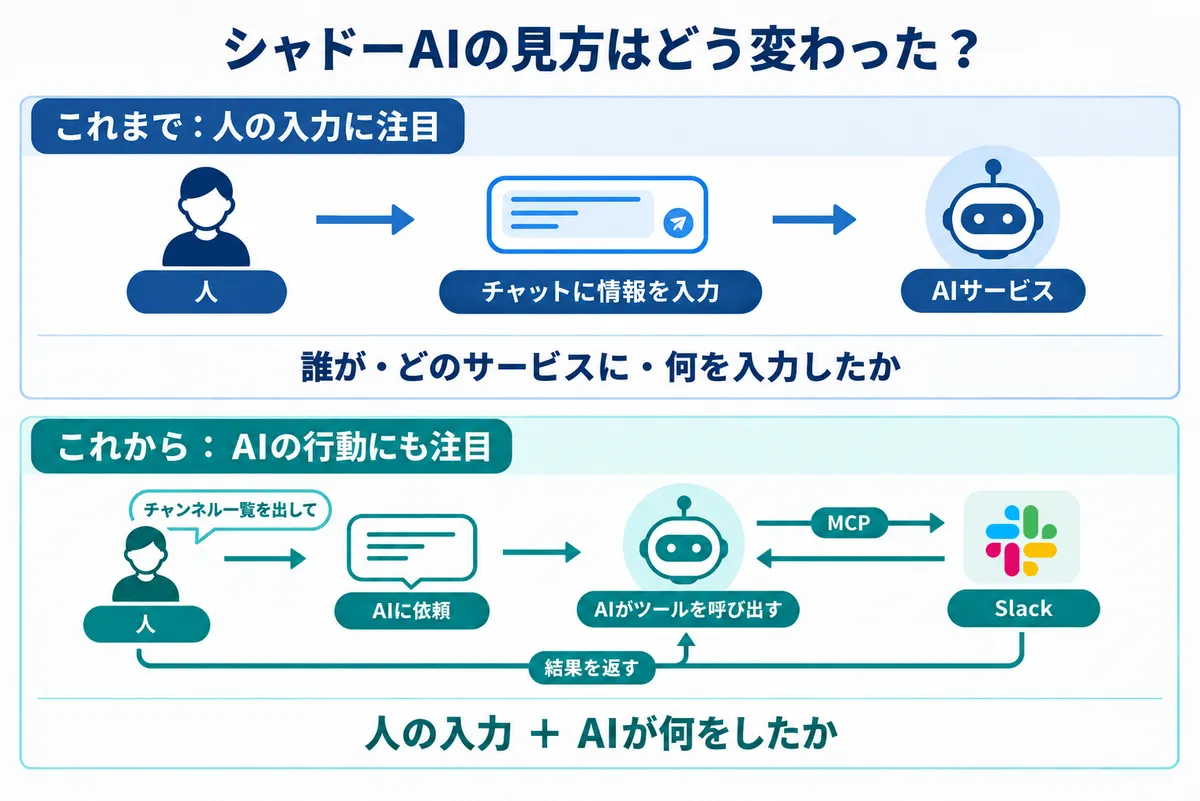
図の上半分が、その構図です。いま起きているのは、下半分のほうです。
MCPという共通の決まりごと
MCP(Model Context Protocol)は、AIが外部のツールやデータに接続するための共通仕様です。AIサービスごとにバラバラだった連携のやり方を、1つの形にそろえたものだと思ってください。
これが入ると、使い方はこう変わります。図の上段が往路、下段が復路です。
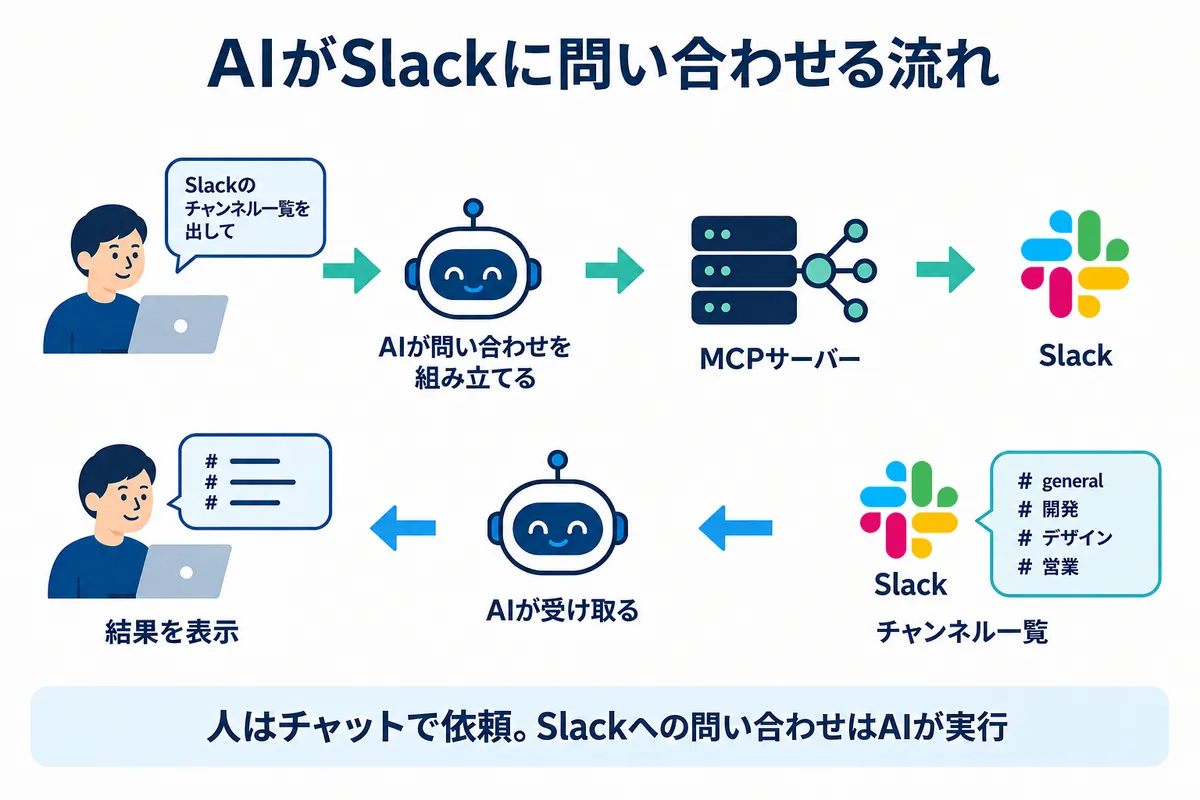
ここでは、MCPを使った外部サービス連携の例としてSlackを取り上げます。実際の検証環境や検証対象を示すものではありません。
たとえば、利用者がチャットに「Slackのチャンネル一覧を出して」と入力した場合、対応するツールが利用できる環境では、AIが必要な問い合わせを組み立てて実行し、その結果を利用者に返すことができます。
- この例では、人はチャット欄から依頼する
- Slackへの問い合わせは、AIが自分で組み立てて実行している
- 人のところには、結果だけが返ってくる
2026年の時点で、ChatGPT や Claude をはじめとする主要なAIサービスがこの仕組みに対応していて、社内のSaaSに繋ぐためのMCPサーバーも各社から提供されています。
見るべき対象が1つ増えた
AIが自分で組み立てて実行した問い合わせは、人が入力した内容とは別物です。これまでは「人が何を入力したか」を見ればよかったのが、これからは「AIが何をしたか」も見ないといけません。
後者が、いまの可視化の空白地帯になっています。
これまでの仕組みは、人が入力する前提で作られてきました。誰がどのサービスを開いたか、そこに何を入力したか。見る場所も、止める場所も、人の操作の近くに置かれています。AIが自分で外部に問い合わせる経路は、その前提の外側にあります。
ただ、前提の外にあるだけなら、見る仕組みを足せば済む話です。MCPの場合は、そう単純にいきません。
MCPが問題を一段深くした、2つの理由
① MCPの通信は、接続経路によって見える場所が変わる
MCPを使ったツール呼び出しは、必ずしも利用者の端末を通るとは限りません。接続のしかたで3つに分かれ、それぞれ通信の出どころが違います。
1つ目は、Web版のAIサービスが自身のクラウド環境からMCPサーバーに接続する構成です。MCP通信はAIサービス側から行われ、利用者の端末を経由しません。
2つ目は、端末上で動くAIクライアントがリモートMCPサーバーに接続する構成です。端末からHTTPS通信が発生します。
3つ目は、ローカルMCPサーバーを使う構成です。たとえば、端末内で標準入出力(stdio)を介して通信する方式があります。
つまり、MCPを使っているというだけでは、ネットワーク機器からその通信を観測できるとは限りません。どこでAIクライアントが動き、どの経路でMCPサーバーに接続しているかによって、見える情報が変わります。
さらに、HTTPS通信が観測できる場合でも、宛先情報だけではツールの呼び出し内容まで把握できません。通信内容を確認するには、適切な検査機能やログとの組み合わせが必要です。
② 私設サーバーを、誰でも立てられる
MCPサーバーは仕様が公開されていて、作るのも難しくありません。社内の誰かが自分用に1つ立てる、ということが普通に起こります。
問題は、そうして立てられたサーバーを、どうやって見つけるかです。
従来のSaaS利用なら、既知のサービス一覧と通信を突き合わせるやり方がありました。たとえば Defender for Cloud Apps は、クラウドアプリのカタログを持っています。「このドメインはこのSaaS」という対応表があるから、未承認のサービスを洗い出せました。
しかし、カタログに載っていないサーバーは、カタログとの照合では見つかりません。通信ログや端末の情報から存在に気づくことはできても、それが何に使われていて、どこにアクセスしているのかまでは、別途確かめる必要があります。
一方、MCPの通信をプロトコルとして解析する仕組みなら、カタログに載っていないサーバーも検出の対象になります。その仕組みで実際に何がどこまで見えるのかは、Part 4 のブログ記事で確かめます。
MCP以前からある問題:人とエージェントの区別がつきにくい
ここまではMCPの話でしたが、MCPが広まる前から続いている問題がもう1つあります。
これは当社のHirokazuさんのNHIの脆弱性と対策|NIST CSF 2.0で考えるガバナンスが、はっきり書いている論点です。
その操作が人によるものかエージェントによるものか、ログからは区別できません。
人とエージェントが同じアカウントの資格情報を使えば、認証ログには同じユーザー名が残ります。ユーザー名だけを見ても、どちらが操作したのかは分かりません。
「誰が使っているか」を把握するには、ユーザー名だけでは足りません。何が識別できるかはログの種類や認証方式によって変わるので、エージェント固有のIDや操作ログと組み合わせて見る必要があります。
可視化には、3つのレイヤーがある
では、どこを見れば分かるのか。整理すると、見る場所は3つあります。
| レイヤー | 主な役割 | 見えるもの | 見えにくいもの |
|---|---|---|---|
| ID層 | ID・認証・権限の管理 | 管理対象のID、認証やアクセス許可の記録 | 管理対象外のエージェントや、認証後の具体的な操作内容 |
| エンドポイント層 | 端末上のプロセス・動作の監視 | 端末上で動くAIクライアントや関連プロセスの挙動 | 利用者の端末を経由しないクラウド間通信 |
| ネットワーク層 | 通信先・通信内容の可視化と制御 | 観測対象の経路を通る通信。条件によってはリクエスト内容 | 観測経路を通らない通信や、復号・解析できない内容 |
※ 各レイヤーの一般的な役割を整理した表です。実際に取得できる情報は、製品・設定・通信経路によって異なります。
3つとも、見えるものと見えないものがはっきり分かれています。どれか1つを入れれば埋まる、という形にはなっていません。
先ほど挙げた3つの経路は、どのレイヤーから見えるのか、順に並べてみます。
- AIサービスのクラウドからMCPサーバーへ出ていく経路 ── 利用者の端末を通らないため、エンドポイント層ではMCP通信そのものを捉えられません。ネットワーク層でも、その通信が観測対象の経路を通らなければ捉えられません
- 端末のAIクライアントからHTTPSで出ていく経路 ── 端末を通るため、エンドポイント層とネットワーク層の両方で観測する対象になります
- 端末内で完結するローカルMCP ── 標準入出力(stdio)でやり取りする部分はネットワーク通信ではないため、ネットワーク層には現れません
これは通信がどこを通るかという構成から導いた整理で、実機で測った結果ではありません。実際にどの情報が記録され、どこに可視化の限界があるのかは、以降の検証で確かめていきます。
エンドポイント層については、先ほどのHirokazuさんの記事がこう書いています。
ローカルAIエージェントの検出や、悪意あるエージェント動作のブロック機能が登場。製品によってはまだプレビュー段階
つまり、可視化レイヤーのどこを見ても、まだ空白があるというのが現在地です。
Microsoftの打ち手:両側から挟む
この空白に対して、Microsoft が打ち出しているのはID層とネットワーク層の両側から挟むという世界観です。
- Entra Agent ID でエージェントのIDを管理する ── AIエージェントに固有のIDを割り当て、認証やアクセス管理につなげる仕組み
- Global Secure Access で観測対象の通信やAI利用状況を把握する
- この2つを組み合わせて、IDと通信の両面から把握できるようにする
IDが管理されているエージェントについて、ネットワーク上の活動をどこまで把握できるのか。管理対象外のエージェントを検出できる条件は何か。IDと通信の情報を組み合わせることで、どこまで確認できるのかを実機で検証します。
GSA 側には、この文脈で3つの機能が用意されています。
- Shadow AI discovery ── 観測対象の通信から、AIアプリの利用状況をアプリ単位で可視化する
- Generative AI Insights ── 対応する生成AIサービスへのプロンプトやMCPの操作を、取得可能な範囲で記録する(プレビュー)
- AI agent discovery ── 対象環境のAIエージェントを検出し、Agent IDの登録状況などを確認する(プレビュー)
※ 検出できる範囲や必要な条件は機能によって異なります。
この3つが実際に何をどこまで見せるのかを、このシリーズで確かめます。それぞれの違いと、動かすまでに必要な前提設定は、Part 2 のブログ記事で整理します。
このシリーズの立場
いま、AI とエージェントに対してどんな統制が求められているのか。その求められている側を先に置いて、GSA がそのうちどこまでをカバーするのかを見ます。
- 見るのは、カバー範囲です。GSA の3つの機能が、何を、どの条件で、どこまで見せるのか。検出した結果が、その後の統制にどうつながるのか
- 他社製品との比較表は作りません。当社は Okta、Netskope、CrowdStrike など複数のスタックを扱っていますが、どれか1つを売りたくて書いているわけでも、製品間の優劣をつけたいわけでもありません
- 知りたいのは、現時点の到達点です。ID管理を提供してきたMicrosoftが、ネットワーク層も含めてAI利用をどこまで可視化・統制できるのか。その実態を、実機で確認していきます。
検証で確認できたこと、確認できなかったこと、そこから考えられる運用上の課題を、できるだけ具体的に書いていきます。
この記事で扱っていないこと
- 実機の検証結果は、まだ1つも出てきません。Part 3 以降のブログ記事で順に出します
- 3つの機能の詳細な仕様、提供状態、必要なライセンス・設定条件はPart 2 のブログ記事で扱います
シリーズの構成
| 内容 | |
|---|---|
| Part 1(この記事) | なぜ「AIを誰が使っているか」が見えなくなったのか |
| Part 2 | GSA の3機能(Shadow AI discovery / Generative AI Insights / AI agent discovery)は何が違うのか。動かすまでに必要なライセンスと設定 |
| Part 3 | Shadow AI discovery ── どのAIアプリを誰が使ったか、どこまで見えるか |
| Part 4 | Generative AI Insights ── プロンプトの中身とMCPの操作は、どこまで記録されるか |
| Part 5 | AI agent discovery ── 端末上のAIエージェントは検出できるか。Agent ID との突き合わせはどうなるか |
| Part 6 | 3機能を通した総括。運用に載せるには何が必要か |
構成は変わる可能性があります。その場合は各記事で触れます。
おわりに
最初の問いに戻ります。
社内で誰がどのAIサービスを使っているか、把握できているでしょうか。
AIが自分で外部のツールを呼ぶようになったいま、「誰がChatGPTを開いたか」だけでは利用実態を説明できません。そのAIがどこに接続し、どのような操作を行ったのか。そこまで見て、ようやく実態が分かります。どこまで見えるかは、AIの実行環境と通信経路、そして使う製品によって変わります。
そして、そこを見るための製品カテゴリには、まだ空白があります。
次回のPart 2のブログ記事では、GSAの3つの機能が何を検出するのか、利用に必要なライセンスや設定とあわせて整理します。
この記事が誰かの役に立ったら嬉しいです。